
INDUSTRY.co.id - JAKARTA — Perusahaan infrastruktur inferensi kecerdasan buatan (AI) asal Indonesia, Netra Runtime, resmi memperkenalkan layanannya kepada publik.
Perusahaan ini menawarkan teknologi untuk mempercepat proses inferensi AI, meningkatkan efisiensi biaya, serta membantu organisasi menjalankan model AI dengan kendali lebih besar atas infrastruktur dan data mereka.
Peluncuran ini menyasar perusahaan yang ingin mengoptimalkan penggunaan AI tanpa harus selalu berinvestasi pada perangkat keras mahal atau membangun sistem inferensi dari awal. Bagi organisasi yang menangani data sensitif, Netra juga menawarkan opsi penerapan privat agar pemrosesan model dan data tetap berada dalam kendali pelanggan.
Di tengah meningkatnya kebutuhan komputasi AI, Netra menempatkan performa inferensi sebagai fokus utama. Perusahaan menilai bahwa kemampuan menjalankan model AI saja belum cukup. Tantangan sebenarnya adalah memastikan model dapat melayani permintaan pengguna dengan cepat, stabil, dan efisien ketika digunakan dalam skala produksi.
“Banyak tim bisa menjalankan sebuah model AI. Bagian yang sulit adalah menyajikannya dengan throughput tinggi dan latensi rendah di bawah beban kerja nyata, sambil tetap memegang kendali atas infrastruktur dan biaya,” ujar Rifky Bujana Bisry, Founder sekaligus CEO Netra Runtime.
Netra Runtime menawarkan dua pendekatan untuk menjawab kebutuhan organisasi yang berbeda, yakni penerapan perangkat lunak pada infrastruktur milik pelanggan dan layanan inferensi terkelola melalui cloud.
Pertama, Netra Runtime dapat dilisensikan untuk dijalankan langsung pada infrastruktur pelanggan yang telah memiliki GPU. Pendekatan ini memungkinkan perusahaan mengoptimalkan proses inferensi tanpa harus memindahkan model dan data ke lingkungan di luar kendali mereka.
Model penerapan tersebut ditujukan bagi organisasi yang membutuhkan kendali atas lokasi pemrosesan, privasi data, serta pengelolaan infrastruktur internal.
Kedua, Netra Cloud menyediakan layanan inferensi AI terkelola melalui API yang kompatibel dengan OpenAI. Pelanggan dapat mengakses kemampuan inferensi tanpa perlu membeli, mengoperasikan, atau memelihara perangkat keras GPU sendiri. Biaya layanan dihitung berdasarkan penggunaan token.
Kedua layanan tersebut menggunakan teknologi inti yang sama. Dengan demikian, Netra berupaya menjangkau perusahaan yang sudah memiliki infrastruktur komputasi maupun organisasi yang ingin mengakses inferensi AI secara lebih praktis.
Salah satu aspek yang menjadi perhatian Netra adalah pengembangan teknologi pada lapisan teknis di bawah API. Pekerjaan engineering perusahaan mencakup kernel inferensi, jalur runtime, penjadwalan, serta berbagai komponen yang memengaruhi kinerja penyajian model AI dalam skala besar.
Netra telah memublikasikan kernel inferensi dan integrasi runtime untuk model Deepseek v4.1 Flash pada GPU AMD Instinct MI350X. Perusahaan juga merilis repositori Netra Kernel dengan lisensi open source MIT, sehingga para engineer dapat memeriksa implementasi dan validasi teknologinya.
Langkah tersebut menjadi bagian dari upaya Netra untuk memperlihatkan kemampuan teknisnya secara terbuka. Selain memublikasikan hasil benchmark, perusahaan juga mengundang calon pengguna untuk menguji teknologi tersebut menggunakan model, perangkat keras, dan pola trafik mereka sendiri.
Dalam benchmark terbarunya, Netra melaporkan throughput prefill mencapai 73.527 input token per detik pada concurrency 32 tanpa cache.
Pada pengujian decode, konfigurasi empat GPU AMD Instinct MI350X mencatat aggregate throughput sebesar 5.062 output token per detik pada concurrency 32. Sebagai pembanding, Netra melaporkan throughput 2.870,2 output token per detik pada konfigurasi dua GPU NVIDIA B300 dan 2.497,8 output token per detik pada empat GPU NVIDIA B300.
Sementara itu, pada concurrency 1, kecepatan decode per pengguna dilaporkan mencapai 1.152 token per detik menggunakan empat GPU AMD Instinct MI350X. Angka pembanding yang dicantumkan Netra adalah 498,8 token per detik pada dua GPU NVIDIA B300 dan 608,6 token per detik pada empat GPU NVIDIA B300.
Hasil tersebut merupakan klaim benchmark yang dipublikasikan Netra dan bukan jaminan bahwa setiap konfigurasi akan menghasilkan performa serupa. Kinerja inferensi dapat berbeda bergantung pada model AI, jenis perangkat keras, karakteristik beban kerja, dan konfigurasi sistem.
Karena itu, Netra mendorong calon pelanggan untuk melakukan pengujian langsung menggunakan kebutuhan operasional mereka sebelum menentukan konfigurasi yang paling sesuai.
Selain mengembangkan teknologi inferensi, Netra mulai mencatat penggunaan platform dari pengguna dan mitra.
Dalam strategi pemasaran dan distribusinya, Netra menggabungkan publikasi bukti performa, akses bagi pengembang, serta kemitraan dengan penyedia layanan teknologi.
Perusahaan memublikasikan benchmark dan temuan engineering sebagai referensi bagi calon pelanggan yang ingin mengevaluasi kemampuan teknologi inferensi AI. Pengembang juga dapat mencoba Netra Cloud secara langsung untuk mengenal layanan yang ditawarkan.
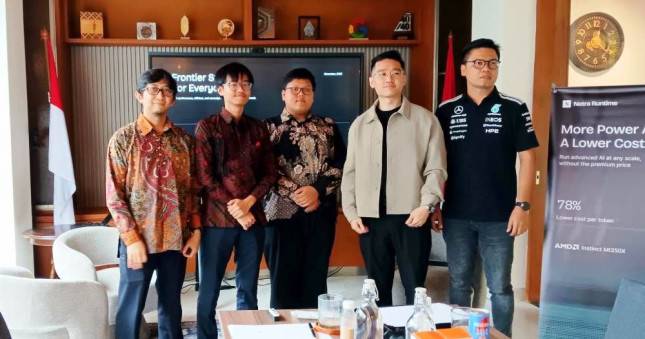
Peluncuran Netra Runtime turut menghadirkan sejumlah tokoh dari ekosistem teknologi dan investasi, termasuk Founding Partner Init-6 Nugroho Herucahyono, Alifais Farrel Ramdhani, Head of AMD Indonesia Brando Lubis, serta Raymond Chin, CEO Genesis Venture House sekaligus founder Nalar.